燧弘华创入选中国信通院Token服务能力攀登计划
随着大模型应用加速落地,Token正成为连接算力、模型与AI应用的重要服务单元。国家数据局数据显示,2026年3月,我国日均Token调用量已超过140万亿,较2024年初增长1000多倍。Token规模快速增长,也意味着行业对服务能力提出更高要求——从“模型能调用”,进一步走向高性能、高稳定、可规模化的Token服务。
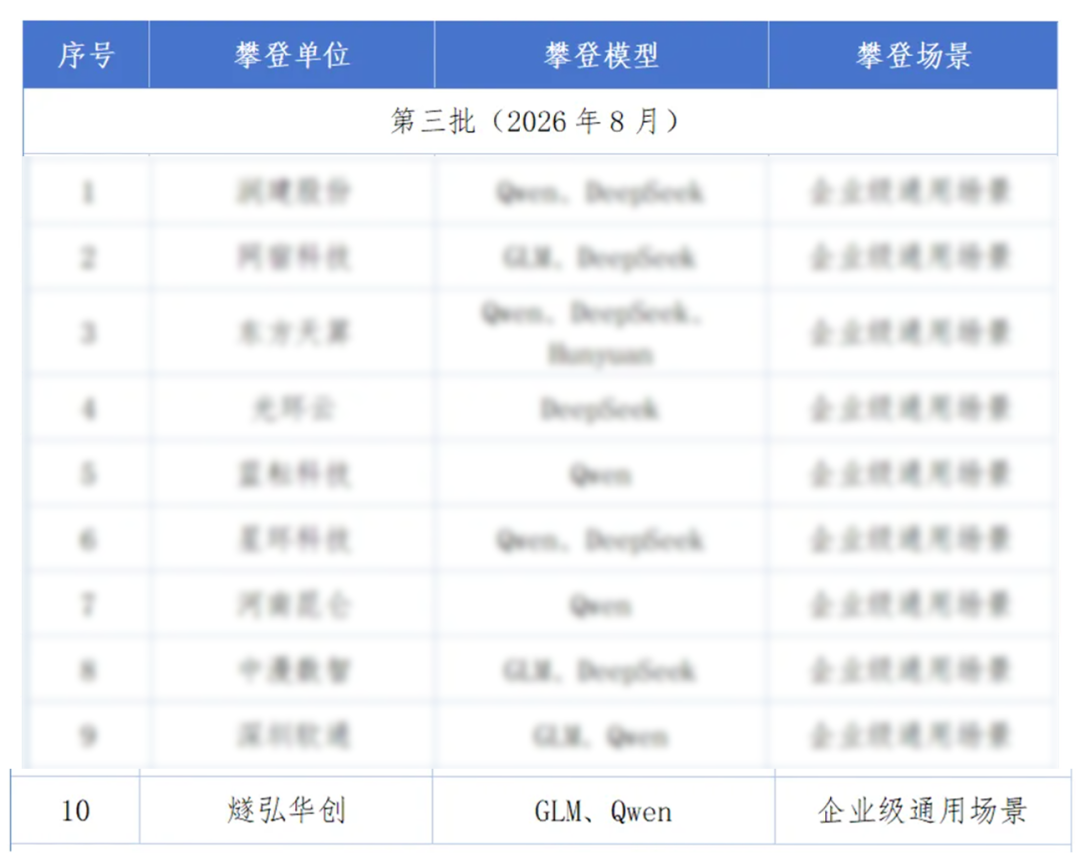
近日,燧弘华创入选中国信息通信研究院(以下简称"中国信通院")人工智能研究院公第三批"词元服务能力攀登计划"(以下简称"攀登计划"),并接受测模型基线性能测试。测试围绕吞吐能力、响应时延、服务成功率和错误率等核心指标,对Qwen、GLM两款模型进行统一环境下的压力测试。结果显示,两款模型全部通过基线验收,8项指标检查无一短板,核心性能指标大幅领先基线要求,整体服务在持续压力下保持稳定,充分验证燧弘华创在模型服务性能、稳定性及工程化交付方面的综合能力。
本次测试累计执行513个请求,生成约627万Token,实现100%调用成功率、0%错误率。两款模型在成功率、错误率等稳定性指标上均满分通过,整体具备规模化生产落地条件。从测试表现来看,Qwen展现出更强的吞吐与响应能力,在高并发、长文本及对服务效率和成本较为敏感的场景中具备明显优势;GLM则表现出更好的吞吐稳定性,适合对服务均一性和SLA可预测性要求较高的生产场景。两款模型形成能力互补,也体现燧弘华创针对不同业务需求进行模型适配、资源调度和服务优化的能力。
基线达标总览
“快”与“稳”兼备,背后体现的是燧弘华创贯穿算力底座、模型适配、推理优化、智能调度和服务管理等环节的工程化能力。依托自研HonMaaS平台,燧弘华创将异构算力资源与多模型服务能力进行统一整合,通过算力调度、智能路由、负载均衡、流量治理等机制,实现算力资源的动态匹配与高效利用,并建立覆盖模型接入、资源调用和服务交付的统一管理体系,让底层算力持续转化为稳定、高效的Token服务。
在模型适配方面,HonMaaS已持续接入DeepSeek、GLM、Qwen、MiniMax等主流模型,并能够在新模型发布后快速完成适配,让不同模型能力能够更快进入实际应用。平台支持多模型统一管理与灵活调用,业务侧无需重复改造即可根据实际需求切换模型和算力资源;同时,围绕企业生产环境,平台进一步提供计量计费、安全合规、权限管控、告警监控和调用追溯等能力,兼顾公有云在线服务与私有化部署需求。
基于这一能力体系,HonMaaS已覆盖智能客服、知识库问答、Agent智能体、多模态内容生成、具身智能、代码推理、通用办公等多元企业AI场景,形成从算力调度、模型管理到Token服务交付的一站式智算底座。
此次通过信通院“攀登计划”基线测评,是对燧弘华创Token工厂全链路服务能力的一次集中检验,也进一步验证了其将算力资源、模型能力转化为稳定可靠生产级Token服务的工程实力。面向AI产业由“模型竞争”走向“服务竞争”的新阶段,燧弘华创将继续以算力为底座、模型为核心、HonMaaS平台为纽带,持续提升算力资源利用效率、模型服务性能和Token交付能力,推动Token服务从“可度量”进一步走向“可信赖”,为千行百业的AI应用落地提供更加高效、稳定、普惠的算力与大模型服务支撑。